Da Incerteza à Probabilidade
Antes de aprender a calcular probabilidades, queremos responder uma pergunta anterior:
Por que precisamos de uma Teoria das Probabilidades?
Para isso, precisamos primeiro entender que tipo de fenômeno estamos tentando estudar.
Fenômenos determinísticos e estocásticos
Antes de falar em probabilidade, precisamos distinguir dois tipos de fenômenos.
Fenômenos determinísticos
Considere a função \(y=f(x)=2x+1\).
Se conhecemos o valor de \(x\), o valor de \(y\) está completamente determinado. Por exemplo, se \(x=3\), então necessariamente \(y=f(3)=7\).
Não existe incerteza sobre o resultado dentro desse modelo.
A mesma ideia aparece em situações simples do mundo real. Se a receita de uma venda é definida por \(\text{Receita}=\text{Preço}\times\text{Quantidade}\), então, sabendo que \(\text{Preço}=50\) e \(\text{Quantidade}=100\), temos necessariamente \(\text{Receita}=5.000\).
Fixadas as informações relevantes e o mecanismo que relaciona essas informações ao resultado, o resultado está determinado.
Chamamos um mecanismo desse tipo de determinístico.
Podemos representar essa ideia de forma simples como \(x \longrightarrow f \longrightarrow y\).
Conhecido \(x\) e conhecido o mecanismo \(f\), conhecemos \(y\).
Fenômenos estocásticos
Agora considere outro problema.
Um usuário chega ao checkout de um e-commerce.
Conhecemos várias de suas características:
- dispositivo utilizado;
- país;
- origem da sessão;
- horário;
- produtos no carrinho.
Ainda assim, essas informações não necessariamente determinam se aquele usuário fará uma compra.
Podemos observar compra ou não compra.
Existe, portanto, incerteza sobre o resultado particular que será observado.
Esse é o tipo de situação que chamaremos de fenômeno estocástico. Mas estocástico não significa ausência completa de estrutura.
Essa será justamente a próxima ideia.
Essa distinção aparece imediatamente em Machine Learning.
Um modelo pode receber dezenas de características de um usuário — histórico de compras, dispositivo, país, horário, origem da sessão — e ainda assim não ser capaz de determinar com certeza se ele comprará.
Em muitos problemas, o que queremos aprender é algo como \(P(\text{compra}\mid \text{informações do usuário})\), ou seja, qual é a chance de um usuário realizar uma compra, dados suas características? (nós vamos aprender sobre essa notação, não se preocupe)
Ou seja: o objetivo não é eliminar a incerteza, mas representá-la e aprender sua estrutura.
Isso vale para problemas como conversão, churn, fraude, default e retenção.
Incerteza
A palavra incerteza será fundamental ao longo deste curso.
Por enquanto, podemos entendê-la de maneira simples:
Existe incerteza quando não conseguimos determinar antecipadamente qual resultado particular será observado.
Por exemplo, suponha que a taxa de conversão de um produto esteja próxima de 5%.
Isso não significa que sabemos se um usuário específico fará uma compra. Para um determinado usuário, observaremos apenas um dos dois resultados: compra ou não compra.
O resultado individual permanece incerto.
Mas algo interessante acontece quando começamos a observar muitos usuários.
Acaso e Regularidade
Spanos utiliza a expressão chance regularity1, que podemos traduzir como acaso e regularidade, para descrever uma característica fundamental dos fenômenos estocásticos.
Ela combina duas ideias que, à primeira vista, podem parecer contraditórias:
\[ \underbrace{\text{Acaso}}_{\text{incerteza nos resultados individuais}} \;+\; \underbrace{\text{Regularidade}}_{\text{regularidade quando observamos muitos resultados}}. \]
Ou, de maneira mais intuitiva:
desordem no nível individual, regularidade no agregado.
Considere, por exemplo, lançamentos sucessivos de dois dados.
Antes de cada lançamento, não sabemos exatamente qual será a soma observada. Ela pode assumir qualquer valor entre \(2\) e \(12\).
Uma sequência como \(7,\;4,\;10,\;6,\;7,\;9,\;3,\;8,\ldots\) pode parecer bastante irregular. O próximo resultado permanece incerto.
Entretanto, existe uma estrutura por trás desses possíveis resultados.
Existe uma estrutura por trás da incerteza
Considere todas as maneiras pelas quais a soma dos dois dados pode ser obtida.
A soma \(2\) pode ocorrer de apenas uma maneira: \((1,1)\).
A soma \(3\) pode ocorrer de duas: \((1,2)\) e \((2,1)\).
Já a soma \(7\) pode ocorrer de seis maneiras: \((1,6)\), \((2,5)\), \((3,4)\), \((4,3)\), \((5,2)\) e \((6,1)\).
Depois disso, o número de possibilidades começa a diminuir novamente.
A estrutura completa é:
| Soma | Número de combinações |
|---|---|
| 2 | 1 |
| 3 | 2 |
| 4 | 3 |
| 5 | 4 |
| 6 | 5 |
| 7 | 6 |
| 8 | 5 |
| 9 | 4 |
| 10 | 3 |
| 11 | 2 |
| 12 | 1 |
Podemos visualizar essa estrutura:
Observe o formato.
A soma \(7\) está associada ao maior número de combinações, enquanto \(2\) e \(12\) estão associadas a apenas uma combinação cada.
Portanto, mesmo antes de desenvolvermos formalmente a Teoria das Probabilidades, já conseguimos perceber algo fundamental:
a incerteza pode possuir estrutura.
Não conseguimos determinar qual será o próximo resultado.
Mas conseguimos identificar uma estrutura entre os possíveis resultados.
A tabela acima conta possibilidades.
Contar possibilidades e calcular probabilidades não são, em geral, a mesma coisa.
Mais adiante veremos que, sob uma determinada lei de probabilidade — por exemplo, quando certos resultados são considerados igualmente prováveis — essa estrutura de contagem poderá ser utilizada para calcular probabilidades.
Essa distinção será muito importante.
Exemplo resolvido
Por que a soma \(7\) possui mais possibilidades do que a soma \(2\)?
Para obter \(2\), existe apenas uma combinação: \((1,1)\).
Para obter \(7\), existem seis: \((1,6)\), \((2,5)\), \((3,4)\), \((4,3)\), \((5,2)\) e \((6,1)\).
Logo, a própria estrutura dos possíveis resultados já distingue \(7\) de \(2\).
Isso ainda não constitui, por si só, uma lei de probabilidade.
Mas é uma primeira indicação de que o fenômeno possui uma estrutura probabilística que precisamos formalizar.
É justamente isso que faremos nas próximas seções.
A Ideia de Repetição
Existe uma ideia que aparecerá repetidamente ao longo de todo o curso:
imaginar que o mesmo experimento possa ser realizado muitas vezes sob as mesmas condições.
Para sermos precisos, vamos fixar a terminologia desde já.
Neste exemplo, chamaremos de experimento o procedimento de lançar dois dados uma vez e registrar sua soma.
Cada realização desse mesmo experimento será chamada de ensaio (trial).
Portanto, não estamos imaginando vários experimentos diferentes. Estamos imaginando vários ensaios do mesmo experimento.
Em um único ensaio, observamos apenas um resultado, por exemplo, \(7\).
Esse único resultado nos diz muito pouco sobre a estrutura do fenômeno.
Agora imagine realizar o mesmo experimento muitas vezes. Se fizermos \(n\) ensaios, podemos representá-los como \(\text{Ensaio}_1,\text{Ensaio}_2,\ldots,\text{Ensaio}_n\).
Cada ensaio produz um resultado particular, como \(7,\;4,\;10,\;6,\;7,\;9,\;3,\;8,\ldots\).
O resultado de cada ensaio continua sendo incerto.
Mas agora temos algo que não existia quando olhávamos apenas para uma realização:
podemos observar como os diferentes resultados se comportam ao longo de muitos ensaios do mesmo experimento.
Essa mudança de perspectiva será fundamental:
\[ \begin{aligned} \text{um ensaio} &\longrightarrow \text{incerteza sobre um resultado particular} \\[0.5em] \text{muitos ensaios do mesmo experimento} &\longrightarrow \text{possibilidade de observar regularidades} \end{aligned} \]
A noção de realizar teoricamente muitos ensaios do mesmo experimento sob as mesmas condições será utilizada diversas vezes ao longo do curso.
Mais adiante, ela nos ajudará a entender conceitos como:
- probabilidade como frequência de longo prazo;
- valor esperado;
- Lei dos Grandes Números;
- amostragem;
- distribuição amostral;
- Inferência Estatística.
Por enquanto, precisamos apenas guardar duas ideias:
- o experimento é o mesmo; o que se repete são seus ensaios.
- o resultado de cada ensaio pode permanecer incerto mesmo quando muitos ensaios revelam um padrão extremamente regular.
Neste momento estamos usando informalmente a expressão “sob as mesmas condições”.
Mais adiante, veremos como essa ideia pode ser formalizada matematicamente através de conceitos como independência e distribuição idêntica.
Uma Lei Estável de Frequências Relativas
Agora podemos entender melhor uma das regularidades mais importantes que aparecem quando realizamos muitos ensaios do mesmo experimento.
Suponha que realizamos \(n\) ensaios do mesmo experimento.
Escolha algum resultado ou evento de interesse, que chamaremos simplesmente de \(A\).
Podemos perguntar:
Em qual proporção dos \(n\) ensaios o evento \(A\) ocorreu?
Essa proporção é chamada de frequência relativa de \(A\):
\[ \text{Frequência relativa de } A = \frac{\text{Número de ensaios em que } A \text{ ocorreu}} {\text{Número total de ensaios}} \]
Por exemplo, se realizarmos \(100\) ensaios do experimento de lançar dois dados e a soma \(7\) aparecer em \(18\) deles, sua frequência relativa observada será \(\frac{18}{100}=0{,}18\).
Se realizarmos um novo conjunto de \(100\) ensaios do mesmo experimento, não esperamos necessariamente obter exatamente a mesma frequência relativa.
Podemos encontrar, por exemplo, \(0{,}15\), \(0{,}19\), \(0{,}17\), \(\ldots\).
As frequências relativas também apresentam variação.
Entretanto, quando o número de ensaios aumenta, algo notável tende a acontecer:
as frequências relativas deixam de variar de maneira arbitrária e começam a se estabilizar em torno de determinados valores.
É essa regularidade que Spanos chama de uma stable law of relative frequencies, ou lei estável de frequências relativas.
Temos, portanto, duas escalas diferentes:
\[ \underbrace{\text{resultado de um ensaio}}_{\text{incerto}} \qquad\text{e}\qquad \underbrace{\text{comportamento de muitos ensaios}}_{\text{regular}} \]
Essa é uma das manifestações mais importantes da ideia de acaso e regularidade.
Neste momento, ainda não definimos formalmente o que é uma probabilidade.
A frequência relativa é algo que observamos nos dados depois de realizar muitos ensaios do experimento.
A probabilidade fará parte do modelo matemático que construiremos para representar o fenômeno.
Mais adiante veremos por que essas duas ideias estão profundamente conectadas.
Um resultado que explicaremos mais tarde
No final deste módulo, a Lei dos Grandes Números permitirá tornar essa história matematicamente precisa.
Informalmente, veremos que, sob determinadas condições, \(\text{frequência relativa de }A \approx P(A)\) quando o número de ensaios é grande.
Ou, conceitualmente:
\[ \text{modelo probabilístico} \stackrel{\text{é a mesma ideia que}}{\longleftrightarrow} \text{regularidade observada em muitos ensaios}. \]
Não precisamos demonstrar nem formalizar isso agora.
Por enquanto, queremos apenas reconhecer o fenômeno que motivará a teoria.
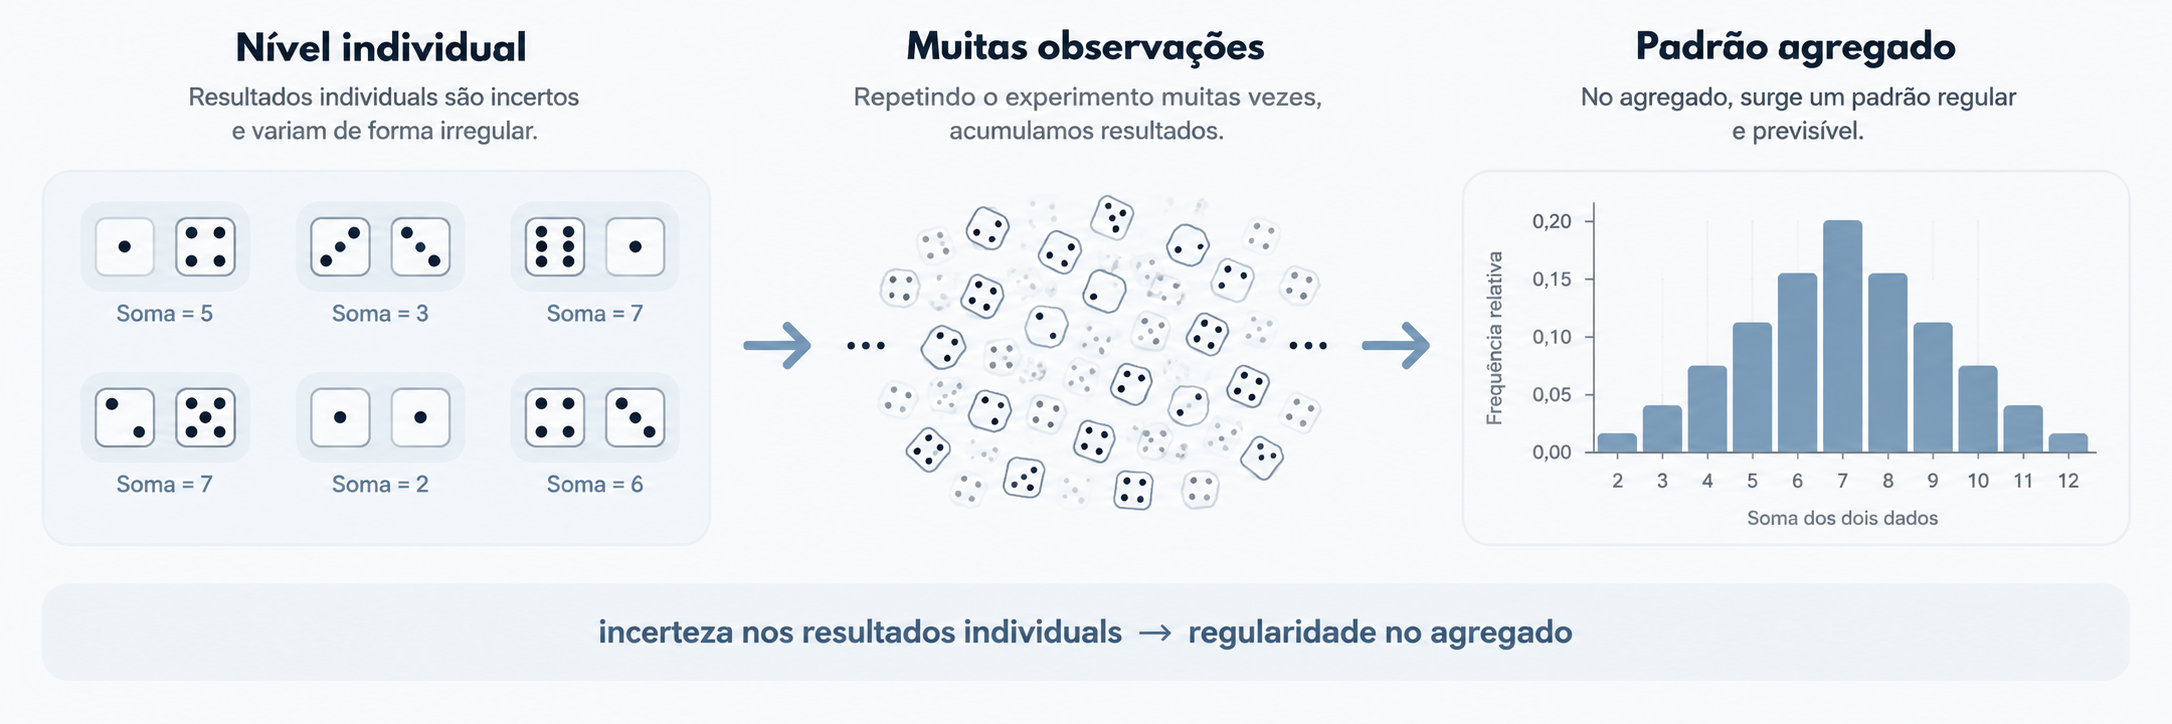
Começamos com incerteza sobre o resultado de um ensaio.
Ao imaginar muitos ensaios do mesmo experimento, descobrimos regularidade nas frequências relativas.
A pergunta agora é:
Como construir uma estrutura matemática capaz de representar simultaneamente essa incerteza e essa regularidade?
Essa estrutura será o modelo probabilístico.
Uma ideia para guardar (Introduzindo a famosa “DGP”)
Se observamos resultados individuais incertos, mas regularidades persistentes quando olhamos muitos ensaios, é natural começar a imaginar que exista algum mecanismo subjacente capaz de gerar esses dados.
Mais adiante, daremos um nome muito importante a essa ideia: Processo Gerador dos Dados, ou Data Generating Process (DGP).
O DGP será uma das ideias centrais quando começarmos a conectar Probabilidade, Inferência Estatística e Inferência Causal.
Mas calma: o DGP vai ter bastante tempo de tela neste curso. Ainda não precisamos dele.
Do fenômeno aos dados
Na prática, não observamos diretamente um mecanismo estocástico.
Observamos seus resultados.
Por exemplo, uma plataforma pode registrar:
| user_id | compra |
|---|---|
| 1 | 0 |
| 2 | 0 |
| 3 | 1 |
| 4 | 0 |
| 5 | 0 |
| … | … |
Esses dados são uma realização particular do fenômeno que estamos estudando.
Isso cria uma distinção que será importante durante todo o curso:
\[ \text{mecanismo que gera os dados} \neq \text{dados que observamos} \]
Os dados são aquilo que vemos ou, na linguagem mais usada na Estatística: é aquilo que observamos!.
Nosso objetivo científico é aprender algo sobre a estrutura subjacente capaz de produzir esses dados.
Que regularidades podemos procurar?
Spanos organiza parte importante dessa estrutura em três dimensões:
\[ \boxed{\text{Distribuição}} \qquad \boxed{\text{Dependência}} \qquad \boxed{\text{Heterogeneidade}} \]
ATENÇÃO!
- Apesar de você estar lendo isso, esse conteúdo é muito importante e vai aparecer por trás de muita coisa no estudo de Probabilidade e Estatística Inferencial. Lá na frente, a gente vai aprender sobre Independência (por exemplo), e relembrar sobre o conceito de “Dependência” vai te ajudar a entender que isso veio de quando tentamos compreender essas tais regularidades presentes na estrutura que observamos na natureza quando agregações ocorrem.
Distribuição
Quais resultados podem ocorrer e com que regularidade?
Por exemplo:
Como se distribui o gasto mensal dos clientes?
Dependência
Observar uma informação nos ajuda a aprender algo sobre outra?
Por exemplo:
Conhecer o tipo de dispositivo utilizado pelo usuário muda o que esperamos sobre sua conversão?
Heterogeneidade
O comportamento probabilístico permanece o mesmo entre diferentes indivíduos, grupos ou momentos?
Por exemplo:
A taxa de conversão é a mesma para todos os mercados e períodos?
Não desenvolveremos essas três ideias agora.
Elas funcionam como um mapa para conceitos que aparecerão repetidamente ao longo do curso.
Por que Teoria das Probabilidades?
Até aqui temos:
- fenômenos cujos resultados individuais são incertos;
- estrutura e regularidade apesar dessa incerteza;
- dados que representam realizações desses fenômenos.
Precisamos agora de uma linguagem matemática que nos permita representar essa incerteza e sua estrutura de maneira sistemática.
Mas o que significa, exatamente, pensar de maneira sistemática?
O que significa pensar sistematicamente?
Uma teoria matemática não é simplesmente uma coleção de fórmulas.
Ela estabelece um framework: definimos objetos, estabelecemos regras ou premissas e, a partir delas, usamos lógica para descobrir quais conclusões necessariamente seguem.
A estrutura básica é:
\[ \text{premissas} \quad+\quad \text{regras} \quad\Longrightarrow\quad \text{consequências}. \]
Ou, de maneira ainda mais abstrata, o famoso \(P \Longrightarrow Q\):
se aceitamos \(P\) dentro do framework, então \(Q\) deve seguir logicamente.
Considere um exemplo simples.
Definimos \(\text{Receita}=\text{Preço}\times\text{Quantidade}\) e assumimos que \(\text{Preço}=50\) e \(\text{Quantidade}=100\).
Então segue necessariamente que \(\text{Receita}=5.000\).
A matemática não está afirmando que toda empresa vende 100 unidades a R$ 50. Ela está dizendo:
se essas são as premissas que adotamos, então essa conclusão segue delas.
Pensar sistematicamente significa justamente deixar explícito de onde partimos, quais regras estamos utilizando e até onde elas nos permitem chegar.
Essa distinção será fundamental durante todo o curso.
A matemática pode nos dizer corretamente:
se estas premissas forem verdadeiras, então estas consequências seguem.
Mas ainda precisamos perguntar:
essas premissas representam bem o fenômeno que estamos estudando?
Por exemplo, podemos construir um modelo supondo que todos os usuários de um site possuem a mesma probabilidade \(p\) de comprar. A matemática nos dirá exatamente o que segue dessa hipótese.
Mas se usuários de países, campanhas ou períodos diferentes tiverem comportamentos muito distintos, o problema não estará na matemática: estará na premissa que escolhemos para representar o mundo.
Em resumo:
a matemática garante a lógica das consequências; a modelagem precisa justificar as premissas.
É exatamente esse tipo de estrutura que construiremos para fenômenos estocásticos.
Em vez de raciocinar informalmente sobre palavras como “chance”, “sorte” ou “incerteza”, vamos definir cuidadosamente objetos como experimento, resultado, espaço amostral e evento, e estabelecer regras que uma lei de probabilidade deve satisfazer.
É relativamente fácil aprender uma sequência de passos para aplicar uma técnica.
Muito mais importante é conseguir perguntar:
De onde isso vem? Quais premissas tornam isso válido? E o que realmente posso concluir?
Projetos práticos e atividades hands-on são importantes. O problema aparece quando substituem — em vez de complementar — os fundamentos.
O objetivo aqui é justamente construir o framework que permite não apenas aplicar uma técnica, mas entender, questionar e eventualmente criar dentro dela.
A partir daí, muitas propriedades não precisarão ser simplesmente decoradas: poderão ser deduzidas dentro do framework.
Essa linguagem será a Teoria das Probabilidades.
Podemos pensar no caminho que começaremos a construir como:
\[ \begin{gathered} \text{fenômeno estocástico} \\[-0.1em] \downarrow \\[-0.1em] \text{incerteza + estrutura} \\[-0.1em] \downarrow \\[-0.1em] \text{framework matemático} \\[-0.1em] \downarrow \\[-0.1em] \boxed{\text{modelo probabilístico}} \end{gathered} \]
Na próxima seção (Modelos Probabilísticos) começaremos a construir esse framework.
No mundo real
Considere uma empresa de e-commerce acompanhando milhares de visitas ao seu site.
Para cada usuário individual, antes da visita terminar, não sabemos com certeza se ele irá comprar ou não.
Alguns compram. Outros não.
O comportamento individual é, portanto, incerto.
Agora imagine que a empresa observa esse processo durante várias semanas.
Ela pode começar a perceber certas regularidades:
- uma fração relativamente estável dos usuários compra;
- alguns períodos apresentam mais conversões do que outros;
- determinados grupos de usuários parecem comprar com maior frequência.
Ou seja:
\[ \text{incerteza no nível individual} \longrightarrow \text{regularidade quando observamos muitos casos}. \]
Esse é exatamente o tipo de situação que motiva a Probabilidade.
A empresa não precisa saber antecipadamente o resultado de cada usuário para conseguir descrever, comparar e estudar o comportamento do conjunto.
A existência de incerteza individual não significa ausência de estrutura.
Quando observamos muitas realizações de um fenômeno, podem surgir regularidades. É essa combinação de incerteza + regularidade que a Teoria da Probabilidade tentará formalizar.
Antes de finalizarmos: Feynman e o framework
Antes de continuar, assista a este breve vídeo de Richard Feynman, um físico super famoso que já veio ao Brasil, no Rio de Janeiro! Eu gosto muito dele.
O vídeo é engraçado, pois o reporter chega a se assustar com a necessidade do Feynman de mostrar a importância de aprender algo mais profundo para entender um assunto!
Preste atenção especialmente à ideia de que uma explicação só pode ir até certo ponto sem que quem pergunta e quem responde compartilhem um framework de conhecimento e raciocínio.
Ele fala isso no minuto 1:38, mas assita tudo e você vai perceber que ele só conseguiria dar a resposta final se o reporter primeiro aprendesse esse framework, ou seja, só se ele fizesse um PhD em Física!
Imagina, então, quanta coisa você estava perdendo ao não estudar profundamente as coisas! Te convenci?
O objetivo deste curso não é nivelar a discussão por baixo. É ajudá-lo a entrar nesse framework, construindo a linguagem e as ideias necessárias para raciocinar, questionar e criar dentro dele.
O que vem a seguir
Nas próximas seções, introduziremos gradualmente:
\[ \begin{gathered} \text{Experimento} \\[-0.1em] \downarrow \\[-0.1em] \text{Resultado} \\[-0.1em] \downarrow \\[-0.1em] \text{Espaço amostral} \\[-0.1em] \downarrow \\[-0.1em] \text{Eventos} \\[-0.1em] \downarrow \\[-0.1em] \text{Lei de probabilidade} \\[-0.1em] \downarrow \\[-0.1em] \boxed{\text{Modelo probabilístico}} \end{gathered} \]
Mais adiante, variáveis aleatórias permitirão transformar os resultados desses experimentos em quantidades numéricas como:
- conversão;
- receita;
- gasto;
- tempo;
- retenção.
E, finalmente, a Inferência Estatística utilizará os dados observados para aprender sobre o mecanismo probabilístico que os gerou.
Antes de continuar
Tente responder, sem recorrer às definições acima:
Qual é a principal diferença entre um fenômeno determinístico e um fenômeno estocástico?
Por que um fenômeno estocástico não significa simplesmente um fenômeno “caótico”?
O que significa dizer que existe acaso no nível individual e regularidade no agregado?
O exemplo dos dois dados mostra que existe estrutura mesmo antes de definirmos formalmente probabilidades. Que estrutura é essa?
Por que contar possibilidades ainda não é necessariamente o mesmo que calcular probabilidades?
No exemplo dos dois dados, qual é a diferença entre o experimento, um ensaio e o resultado de um ensaio?
Por que imaginar muitos ensaios do mesmo experimento é importante para compreender a ideia de frequência relativa?
Qual é a diferença entre o mecanismo que gera os dados e os dados que efetivamente observamos?
Por que observar frequências relativas aproximadamente estáveis sugere que existe alguma estrutura por trás dos resultados individuais?
Uma empresa observa milhares de visitas ao seu site. Por que o fato de não sabermos se um usuário individual irá comprar não impede que apareçam regularidades quando observamos muitos usuários?
Qual é a semelhança entre repetir o lançamento de um dado e observar muitos casos de um mesmo tipo de fenômeno em um contexto real, como compras em um site?
Se uma empresa observa uma taxa de conversão relativamente estável ao longo do tempo, isso significa que ela consegue prever com certeza o comportamento de cada usuário? Explique.
Spanos, A. (1999). Probability Theory and Statistical Inference: Econometric Modeling with Observational Data. Cambridge University Press.↩︎